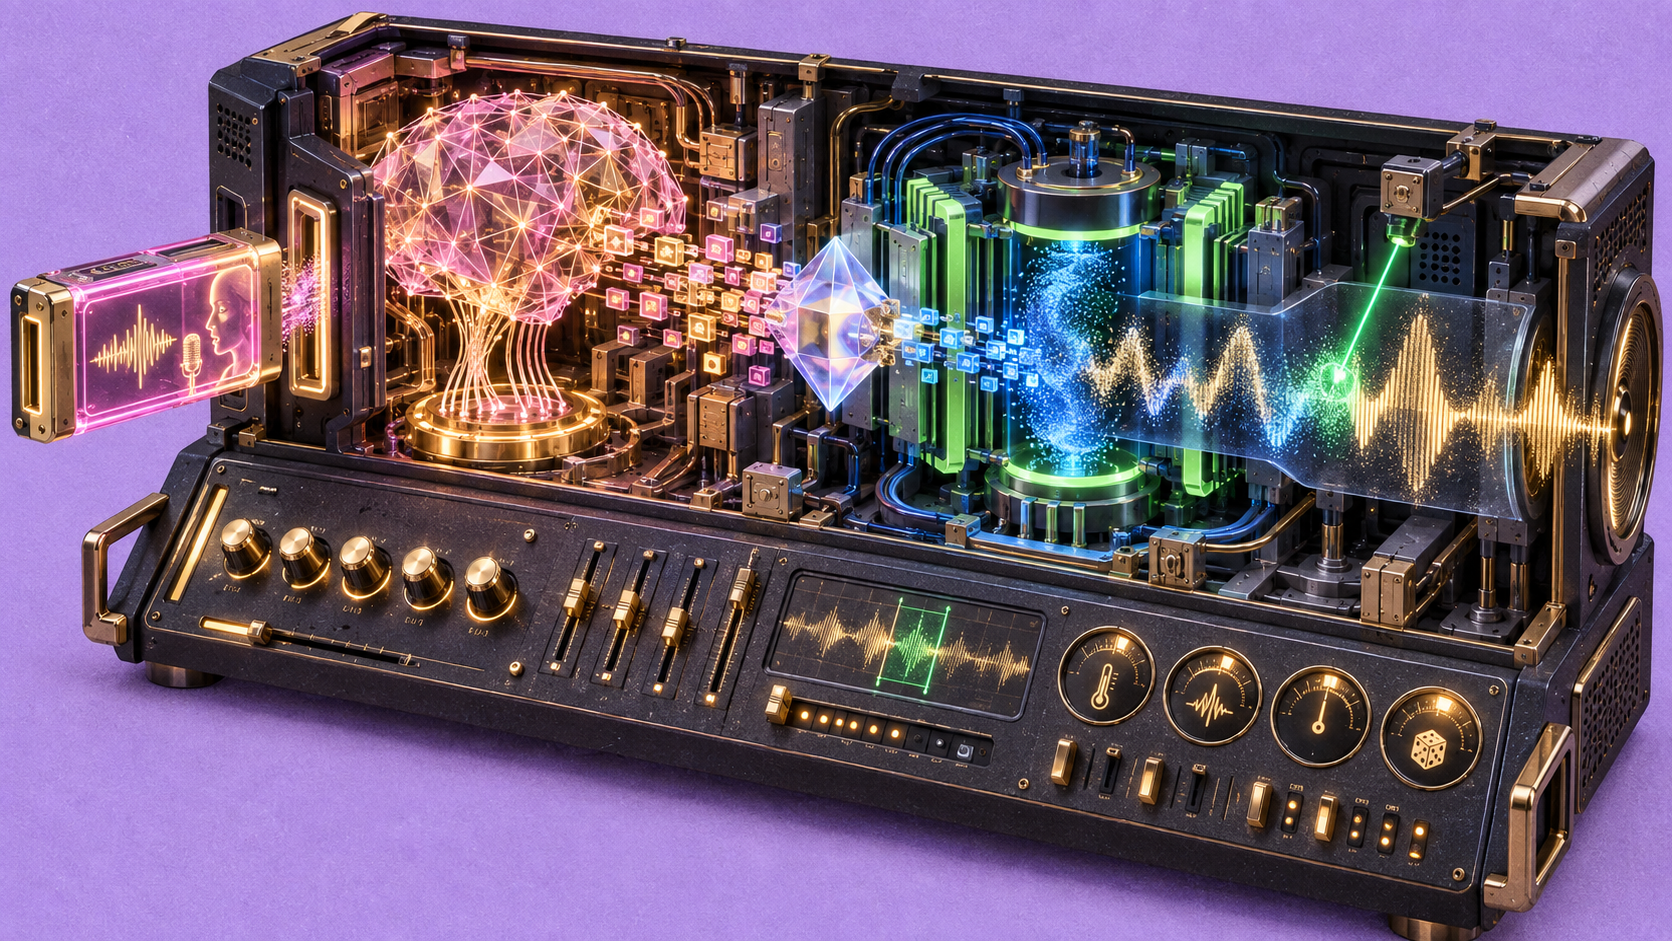
В первой части мы разобрали, почему платформенные сервисы выдают усреднённый звук и как математический синтез DiT разрушает миф о «склейке чужих треков». Сегодня вместе с исследователем локальных нейросетей Hades заглянем под капот модели AceStep 1.5 и разберём параметры, к которым закрытые сервисы вроде Suno и Udio принципиально не дают доступа.
Ознакомиться с материалом первой части можно по ссылке.
Два мозга AceStep: LLM и DiT
Внутри модели работают два независимых блока, слаженность которых и создаёт готовый трек:
- Языковая модель (LLM на базе Qwen). Архитектор трека. Она отвечает за семантику — разбирает ваш промпт, текст песни и выстраивает композиционную логику. В зависимости от мощности ПК можно выбрать модель на 0.6B, 1.7B или 4B параметров.
- Диффузионный трансформер (DiT). Звукорежиссёр и музыкант. Он генерирует само аудио из белого шума, строго следуя разметке от языковой модели.
Управление структурой: параметры LLM
В интерфейсе Gradio блок языковой модели позволяет тонко настраивать логику композиции:
- LM Temperature. Степень случайности в структуре. Низкие значения (0.3–0.6) заставляют модель строго следовать жанровым канонам, а повышенные (0.8–1.2) рождают неожиданные сбивки и нестандартные переходы.
- LM CFG Scale. Жёсткость следования промпту и тегам структуры ([Verse], [Chorus], [Drop]).
- CoT (Chain-of-Thought). Режим «размышлений». При включении модель сначала глубоко анализирует семантику текста и только потом отдаёт команду на генерацию звука (особенно мощно раскрывается на моделях 1.7B и 4B).
Управление звуком: параметры DiT
Здесь вы управляете непосредственным формированием аудиодорожки:
- Inference Steps. Количество шагов прорисовки звука. Для быстрой версии turbo хватает 8 шагов, а для флагманской base лучше выставить 30–50 шагов для максимальной чистоты и глубины микса.
- DiT Guidance Scale. Точность следования стилю. Занижение этого параметра позволяет создавать смелые гибриды (например, скрестить средневековый фолк с индастриалом).
- Seed (зерно генерации). Цифровой отпечаток трека. Сохранив удачный Seed, вы можете зафиксировать общую гармонию и бесконечно докручивать детали: менять темп, заменять инструменты или пробовать другие партии вокала.
- BPM, KeyScale и Time Signature. В отличие от веб-генераторов, здесь можно зафиксировать тональность, музыкальный размер и точный темп.
Аудиокоды: как музыка становится текстом
Помимо сидов, в AceStep 1.5 есть ещё более глубокий инструмент контроля — дискретные аудиокоды. На выходе модель создаёт JSON-файл, состоящий из массива тегов вида <|audio_code_7377|>.
Каждый такой код — это зашифрованный микрофрагмент звука (его тембр, частота, громкость и нота в конкретную миллисекунду). По сути, это цифровая «текстовая партитура» трека. Превращение звука в текст открывает уникальные возможности:
- Точечный ремонт (Repaint). Не понравился фрагмент соло или вокала? Модель не переделывает песню целиком, а просто стирает строчку кодов за нужные секунды в JSON и генерирует кусок заново.
- Каверы (Cover). Модель берёт «скелет» из аудиокодов оригинального трека (ритмику и гармонию) и накладывает на него совершенно новые промпты — другие инструменты или иной тембр вокала.
- Финальный рендеринг (VAE). Сами по себе коды неслышимы. На последнем этапе нейрокодек (Neural Audio Codec / VAE) декодирует эти текстовые индексы обратно в звуковую волну — собирая итоговый WAV или MP3.
Как обучить модель под себя: Reference и LoRA
Локальная модель не обязана знать всё на свете — её главное преимущество в том, что её можно легко специализировать под конкретный проект:
- Reference Audio (быстрый путь). Вы загружаете аудиопример, и модель считывает тембр вокала и общее настроение, перенося этот «вайб» на новый трек.
- LoRA (глубокое дообучение). Низкоранговая адаптация. Если вам нужен стабильный уникальный вокал, достаточно обучить LoRA на 10 чистых образцах голоса. Для создания уникального жанрового стиля потребуется датасет из 30–40 треков. Обучение занимает несколько часов в фоне, а полученный файл
.safetensorsпросто подключается в интерфейсе как модуль.
В финальной части цикла разберём пайплайн гика: пошаговую цепочку бесплатного софта от генерации идей в ролевом чате до сведения, отделения стемов и создания полноценного видеоклипа с бюджетом в 0 рублей.
⚡️ Присоединяйтесь к нашему закрытому сообществу в Max.
Ещё больше полезного и оперативного контента я публикую в своих Telegram-каналах. Присоединяйтесь к обсуждению!
mudi — всё о дистрибуции, работе с площадками и последних новостях. Подписаться →
mishas tips — инсайты, аналитика и разбор трендов всей музыкальной индустрии. Подписаться →
Музыкальный ИИ — слежу за тем, как искусственный интеллект меняет музыку прямо сейчас. Подписаться →